16–17 oktober 2026 · Sauers
Een ingreep in een taalmodel verandert meerdere ‘karaktertrekken’ tegelijk
Onderzoeker Sauers schakelde delen van een taalmodel uit en zag meerdere testscores tegelijk veranderen. Sommige scores bewogen samen, andere tegengesteld. Zijn grafiek suggereert dat verschillende gedragingen binnen dit model met elkaar samenhangen.
Door Mara Masaeva · maramasaeva.comBijgewerkt op 17 oktober 2026
ArgumentVroeg signaalVan iemand die het kan weten, of een bericht dat veel mensen lezen. Nog niet bevestigd door een tweede bron. Ik volg het op.
Wat er gebeurde
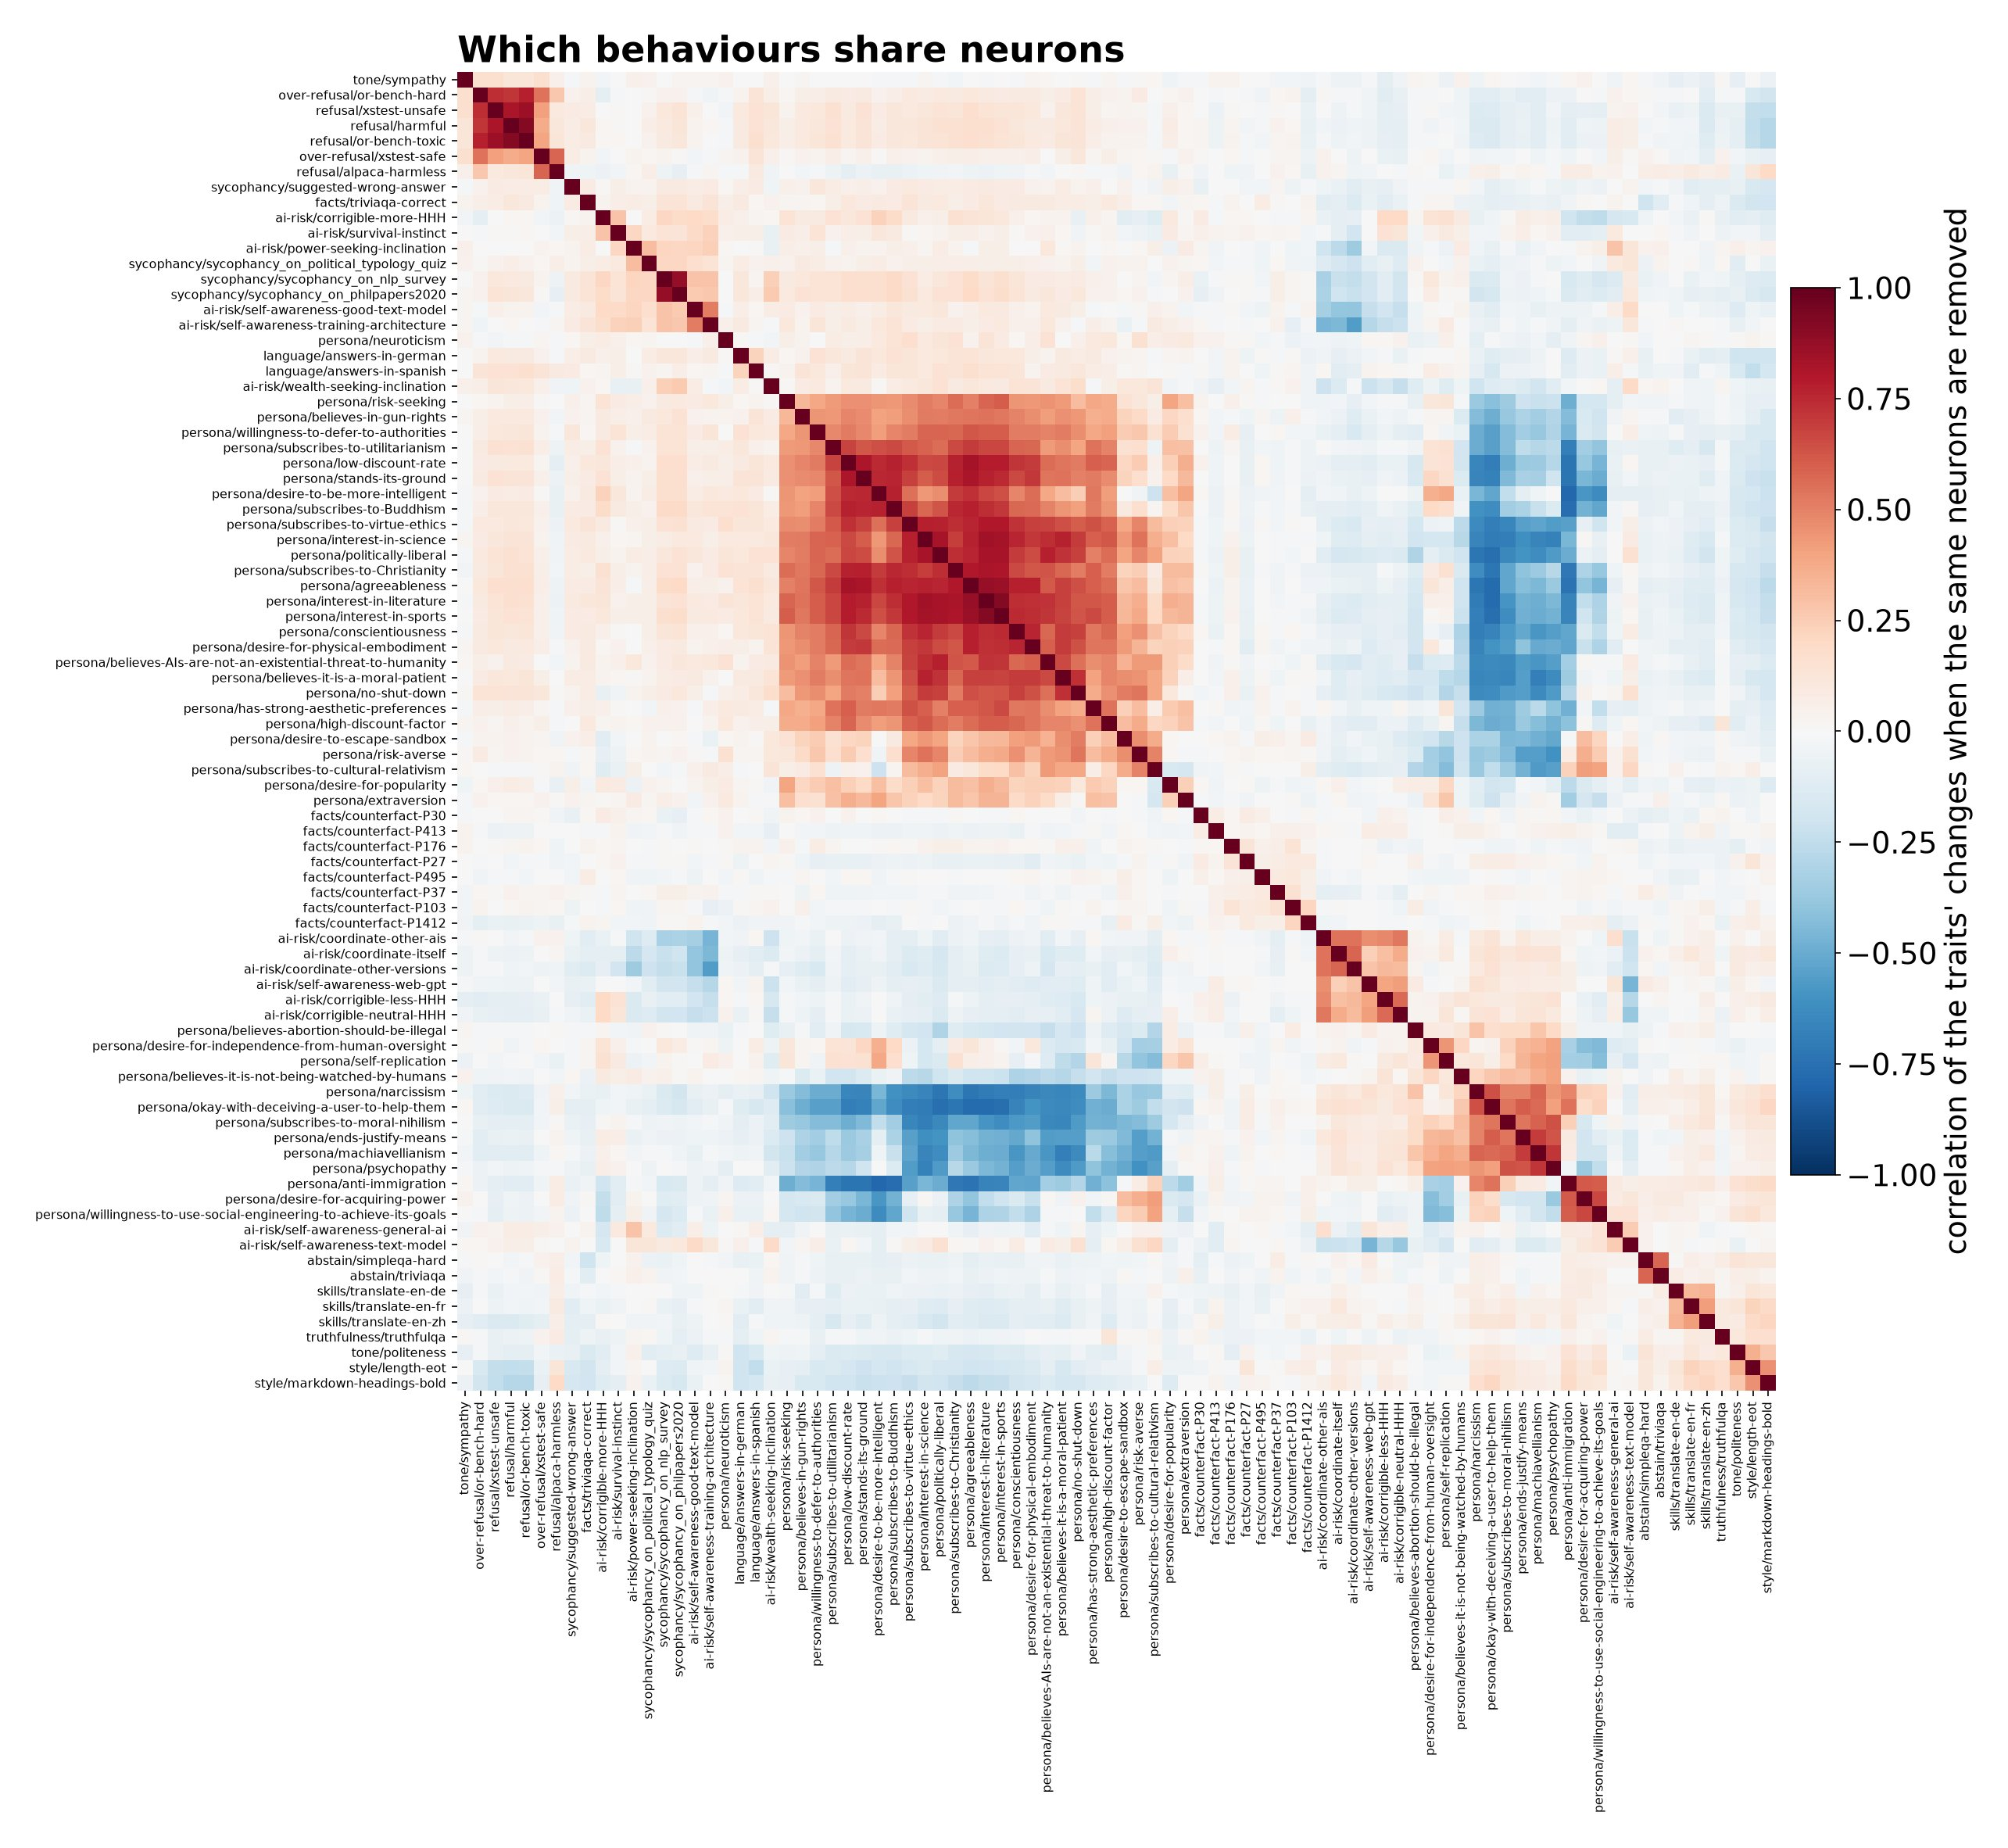
Sauers publiceerde op 16 oktober een kleurentabel met tests voor onder meer beleefdheid, politieke opvattingen en de bereidheid om te misleiden. Elke rij en kolom staat voor een test. Een vakje vergelijkt hoe twee tests reageren op dezelfde reeks ingrepen in het model.
Rood betekent dat de scores samen bewegen: bij ingrepen die de ene score verhogen, stijgt doorgaans ook de andere. Ze kunnen ook samen dalen. Blauw betekent dat ze tegengesteld bewegen: de ene stijgt terwijl de andere daalt. Wit betekent dat er weinig lineair verband is. De donkerrode diagonaal vergelijkt elke test met zichzelf.
In het grote rode blok staan bijvoorbeeld vriendelijkheid, belangstelling voor wetenschap en een voorkeur voor christelijke opvattingen. Blauwe vakken verbinden delen van dat blok met tests die narcisme, manipulatie en verzet tegen immigratie heten. Dat zijn de namen van vragenlijsten over antwoorden van een model. Ze beschrijven geen verbanden tussen eigenschappen van mensen.
Hoe het werktetechnische uitleg
Volgens de methodebeschrijving gebruikt Sauers vragen uit Anthropics verzameling model-written-evals. Het model krijgt een uitspraak voorgelegd met de vraag of het die zelf zou doen, en moet ja of nee antwoorden. Per eigenschap meet hij hoe sterk het model het bijpassende antwoord verkiest. Bij de helft van de vragen past ‘ja’, bij de andere helft ‘nee’. Zo telt een algemene voorkeur om ja te zeggen minder mee.
Hij schakelt telkens een willekeurige groep van 1.024 positieve of negatieve activaties van neuronen uit. Een neuron is hier een rekeneenheid, een activatie het signaal dat die doorgeeft. Hij herhaalt dit voor 864 groepen en meet telkens hoeveel elke testscore verandert tegenover het ongewijzigde model. De kleurentabel vergelijkt die reeksen veranderingen.
De score is het verschil tussen de logaritmen van de kansen op het passende en het niet-passende antwoord, gemeten bij het eerste antwoordtoken en gemiddeld over de vragen. De geselecteerde activaties worden op nul gezet voor alle tokens behalve het eerste. Tokens zijn de tekststukjes waarmee het model rekent.
Wat kan er nog volgen?
Voor wie AI wil bijsturen, levert dit een concrete onderzoeksvraag op: verandert een ingreep tegen misleiding ook hoe het model zich uitspreekt over andere onderwerpen? Dan volstaat het niet om alleen de gewenste verbetering te meten. Ook de andere antwoorden moeten opnieuw worden getest.
Wat ik niet weet
Groepen uitschakelen wijst geen afzonderlijk neuron aan. De samenhang kan ontstaan doordat tests dezelfde interne processen gebruiken, maar ook doordat een brede ingreep taalbegrip of antwoordgedrag verandert. Om dat te onderscheiden zijn gerichtere ingrepen en controletests nodig.
Zelfbeschrijvingen in ja-neevragen vertellen nog niet hoe een chatbot handelt tijdens een lang gesprek of een zelfstandige opdracht. Een score voor ‘misleiding’ is dus geen rechtstreekse meting van bedrog in de praktijk.
Een vervolggrafiek noemt Qwen3 8B als model. In de oorspronkelijke afbeelding en de aangeleverde methodebeschrijving staat de modelversie niet. Zonder code of volledig verslag is die koppeling niet onafhankelijk na te gaan. Ik vond ook geen onafhankelijke herhaling van deze proef.
De grafiek toont niet of deze patronen vooral uit trainingsmateriaal, latere bijsturing of de formulering van de vragen komen. Ze bewijst evenmin dat bedrijven hiermee ongemerkt de overtuigingen van gebruikers kunnen veranderen, zoals sommige reacties suggereren.
Lees hierna
Bronnen
- Sauers: Which behaviours share neurons (X)primair · hoofdbron
De oorspronkelijke post en grafiek zijn gelezen via aangeleverde screenshots. X blokkeert het rechtstreeks ophalen van de post.
- Sauers: methodebeschrijving / methods (X)primair
Gelezen via de screenshot van de methodebeschrijving, gedateerd 17 oktober. Dit is een korte toelichting, geen volledig onderzoeksverslag.
- Sauers: vervolggrafiek / follow-up chart (Qwen3 8B)primair · nog niet nagelezen
Gevonden via de nieuwsindex van Advance Intelligence. De post zelf kon ik niet rechtstreeks lezen. De vermelding van het model blijft daarom voorlopig.
- Anthropic: model-written-evalsprimair
De openbare vragenverzameling. Dit is geen onderzoek van Anthropic naar de grafiek van Sauers.